Une demande d’effacement, et personne ne sait répondre
Un DPO reçoit une demande d’effacement. Une personne pense que ses données figurent dans les réponses d’un assistant conversationnel interne. Le service IT confirme : oui, l’outil tourne sur un modèle fine-tuné en interne, dérivé d’un modèle open source récupéré sur HuggingFace il y a un an.
Question suivante, la vraie : d’où vient le modèle d’origine ? Sur quelles données a-t-il été entraîné avant d’arriver chez vous ? Quels autres modèles dérivés partagent potentiellement la même mémorisation de données personnelles ?
Silence.
Ce silence, nous l’entendons régulièrement en formation. Pas par négligence : parce que personne, dans l’organisation, n’a jamais eu à se poser la question avant que le droit d’effacement ne l’impose. Et c’est précisément le problème.
Ce que la CNIL vient d’améliorer
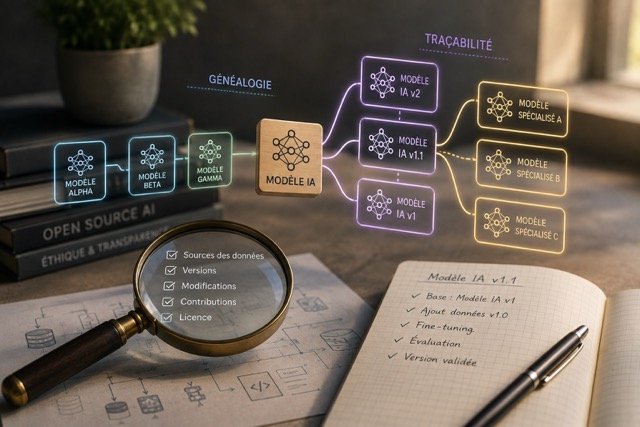
La CNIL a publié une nouvelle version de son démonstrateur Genmod, un outil initialement mis en ligne en novembre 2025, qui permet d’explorer les liens de filiation entre modèles d’IA publiés en source ouverte : ses ascendants (d’où il vient) et ses descendants (ce qu’il a produit).
Selon la CNIL, cette mise à jour rend les recherches nettement plus rapides — une recherche sans limite de profondeur prend en moyenne une vingtaine de secondes — automatise l’actualisation hebdomadaire des données à partir des informations publiques de HuggingFace, et propose désormais une interface bilingue français-anglais.
L’objectif affiché par la CNIL est explicite : identifier, à partir d’un modèle ayant mémorisé des données personnelles, les autres modèles de sa généalogie susceptibles d’avoir conservé les mêmes informations — un enjeu direct pour l’exercice des droits RGPD.
Voilà le fait. Ce qui nous intéresse, c’est ce qu’il change pour vous.
Le trou dans la raquette de vos registres
Dans la quasi-totalité des registres de traitement que nous relisons en formation, la ligne « IA » mentionne un fournisseur, parfois une version de modèle. Rarement une généalogie.
C’est logique : jusqu’ici, personne ne demandait cette information, et les outils pour la reconstituer n’existaient pas vraiment. Résultat, votre AIPD sur un traitement d’IA générative traite le modèle comme une boîte noire figée, alors qu’il s’agit souvent d’un empilement de fine-tuning successifs, chacun ayant potentiellement intégré de nouvelles données d’entraînement.
Ce n’est pas un problème de logiciel. C’est un problème de méthode : on documente ce qu’on voit, pas ce qui se cache derrière.
Or un modèle dérivé peut hériter des biais, des vulnérabilités, et surtout des données mémorisées par son ou ses modèles parents. Si une personne concernée exerce son droit d’accès ou d’effacement, vous devez pouvoir, au minimum, situer votre modèle dans cette chaîne. Sinon, votre réponse au titulaire du droit repose sur une hypothèse, pas sur une analyse.
La question qui manque dans vos échanges fournisseurs
Nous le constatons à chaque session sur l’IA et le RGPD : les entreprises négocient des clauses de sous-traitance, des DPA, des garanties de sécurité. Elles négocient rarement une clause de traçabilité du modèle lui-même.
Pourtant la question est simple à poser, une fois qu’on y pense :
– Le modèle utilisé est-il un modèle de base ou un modèle dérivé (fine-tuné, fusionné, spécialisé) ?
– Le fournisseur peut-il documenter la chaîne de filiation du modèle jusqu’à son ou ses modèles d’origine ?
– Existe-t-il une procédure, chez le fournisseur, pour identifier si des données personnelles ont été mémorisées à un stade de cette chaîne ?
– En cas d’exercice d’un droit, qui, entre vous et le fournisseur, porte l’obligation de remonter cette généalogie ?
Si vous ne savez pas répondre à ces quatre questions pour vos traitements d’IA en cours, vous avez déjà la réponse : votre AIPD est incomplète sur ce point.
Une grille pour intégrer la généalogie à votre AIPD
Nous recommandons d’ajouter, dans la partie « description du traitement » de votre AIPD, une rubrique dédiée à la provenance du modèle. Concrètement :
– Identification du modèle : nom, version, éditeur, statut (open source, propriétaire, hybride).
– Généalogie connue : modèles ascendants identifiés, à date, avec la source de cette information (déclaration fournisseur, outil de traçabilité type Genmod, documentation technique).
– Risque de mémorisation hérité : évaluation qualitative du risque que le modèle ait conservé des données personnelles issues d’un modèle parent.
– Procédure d’exercice des droits : modalités concrètes pour traiter une demande d’accès ou d’effacement compte tenu de cette généalogie, y compris les limites techniques éventuelles.
– Fréquence de mise à jour : la généalogie d’un modèle open source évolue ; une AIPD figée sur ce point vieillit mal.
Cette grille ne coûte pas cher à mettre en place. Elle change en revanche radicalement votre capacité à répondre, le jour où la question tombe.
RGPD et AI Act : deux textes qui convergent sur ce point précis
Ce n’est pas un hasard si la CNIL investit ce sujet maintenant. L’AI Act impose déjà des obligations de documentation technique et de gouvernance des données pour certains systèmes d’IA, notamment ceux à risque. Le RGPD, lui, impose la capacité à répondre aux droits des personnes, indépendamment de la complexité technique du traitement.
La traçabilité généalogique des modèles se situe exactement à l’intersection des deux. Un DPO qui anticipe cette convergence, plutôt que de traiter RGPD et AI Act comme deux chantiers séparés, gagne un temps précieux sur ses prochaines AIPD.
Passer à l’action
Cet outil de la CNIL n’est pas un gadget technique réservé aux data scientists. C’est un instrument de conformité que vous pouvez, dès maintenant, intégrer à votre méthodologie d’AIPD et à vos échanges avec vos fournisseurs d’IA.
Chez Smart RSE, nous formons les DPO et responsables conformité à articuler concrètement RGPD, AI Act et gouvernance des données dans leurs registres et analyses d’impact. Ce sujet de la traçabilité des modèles fait partie des points que nous voyons systématiquement manquer, quel que soit le secteur.
Votre prochaine étape : reprenez votre registre des traitements impliquant de l’IA générative ou du machine learning, et vérifiez, pour chaque ligne, si la question de la généalogie du modèle est ne serait-ce qu’évoquée. Si la réponse est non partout, c’est le bon moment pour structurer cette rubrique — avant qu’une demande de droit ne vous y oblige dans l’urgence.